保留 DSpark 的基础
沿用并行主干与轻量顺序预测头。ReaDy 的重点不是重新发明推测解码,而是补上草稿所需的上下文。
LLM INFERENCE · 论文音频解读
Recurrent States as Dynamic Context
不只复用隐藏特征,让每个草稿位置主动读取所需的上下文。
中文音频解读 · 15 分 30 秒
正在完整加载约 14.9 MB 音频,完成后尝试自动播放;若未响起,点击播放。
已通过全文覆盖检查;发音及补录拼接听感尚未人工核验。
草稿一次写好几个词,怎样才能猜得更准?
推测解码先由轻量草稿模型提出一组候选,再交给目标模型一起验证。草稿越贴近目标模型,单次验证能够接受的 token 就越多。但目标模型已有的隐藏特征,未必突出后续每个草稿位置真正需要的信息。
ReaDy 面向混合线性注意力模型,利用它们已维护的紧凑循环状态。在 DSpark 的草稿结构上,为每个草稿位置生成学习到的查询,直接读取目标模型已提交的循环状态,再以残差更新补充到草稿表示中。
把目标模型的循环记忆,
变成草稿可以按需查询的上下文。
沿用并行主干与轻量顺序预测头。ReaDy 的重点不是重新发明推测解码,而是补上草稿所需的上下文。
用位置相关的学习查询,访问目标模型已经提交的循环状态,并把读出的信息通过残差连接融入草稿表示。
使用低秩状态读取和融合算子降低额外开销,以两阶段适配训练,让更长的接受长度转化为实际吞吐收益。
七项基准的平均解码吞吐量为 302.78 token/s,自回归(AR)基线为 95.86 token/s。相对原始 DSpark 的 280.42 token/s 提高 7.97%;相对额外微调、但不读取状态的基线 286.50 token/s 提高 5.68%。
来源:arXiv 2610.20503v2,主结果与适配消融。这里比较的是解码阶段,不能解释为所有模型或实际请求的端到端耗时都快 3.16 倍。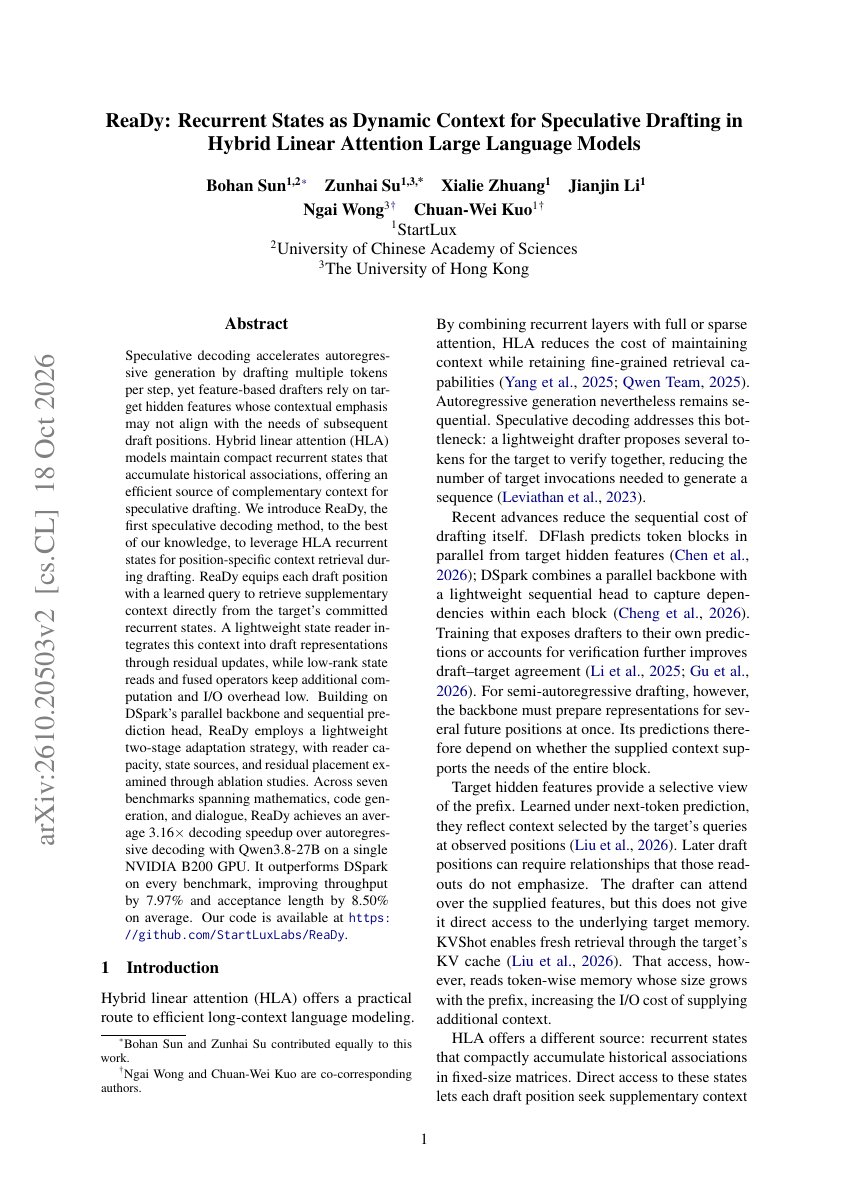 查看完整 PDF
StartLux · University of Chinese Academy of Sciences
The University of Hong Kong
收录 arXiv v2(2026 年 10 月 18 日),PDF 保持原文不变。论文采用 CC BY 4.0 许可;版权归原作者所有。简介为中文解读,以原论文为准。